为什么选择 The AI Hive
有治理的记忆,而不只是记忆
大多数方案只是让 AI 拥有一些记忆,很少有方案为公司提供受治理的流转:谁可以写入、谁可以读取,以及谁来决定哪些内容成为共享知识。
对比
The AI Hive 在各种替代方案中的位置
我们比较的是产品类别,而不是具体产品。每个类别都有适合其设计用途的优秀选项。
| 能力 | 开发者记忆工具包 (例如 Mem0、Zep、Letta) | 供应商自建的助手记忆 | 企业搜索 | 受治理的上下文层 | The AI Hive |
|---|---|---|---|---|---|
| 通过开放标准与任何 AI 应用配合使用 | 部分 | 否 | 部分 | 部分 | 是(大多数供应商处于测试中) |
| 从 AI 工作中学习新事实 | 是 | 是 | 否 | 是 | 是 |
| 人员、团队、项目和公司范围,需经批准 | 部分 | 部分 | 否 | 是 | 是 |
| 客户隔离墙 | 部分 | 否 | 部分 | 是 | 是 |
| 在您自己的服务器上运行 | 部分 | 否 | 部分 | 部分 | 部分(计划中) |
| 对每次读取、写入和审批的审计 | 否 | 部分 | 部分 | 是 | 是 |
| 来自公司数据源的统一受管控的数据流,个人连接器因此可以保持关闭 | 否 | 否 | 是 | 部分 | 部分(Jira、邮箱、数据库已构建;已在测试副本上测试) |
| 在大规模场景下成熟可靠 | 部分 | 是 | 是 | 部分 | 暂无(开发中) |
不同产品的类别各不相同且变化很快;以上是我们截至 2026 年 10 月的总体看法。请核实您所评估的任何产品的具体情况。
连接器
用一个受管控的记忆取代众多连接器
一个人在自己的 AI 应用中开启的每个连接器,都会在公司规则之外,把工具、指令和原始数据添加到模型的上下文中。The AI Hive 在您的服务器上读取公司数据源,并为 AI 提供一个有预算、受管控的上下文。
+3,139 个 token
在一次实测的 Claude Code 测试中,六个闲置的邮件、云盘、日历和文档连接器在被使用之前,就已加到每个请求中。
约 23,400 个 token
加载一个邮件连接器的 30 个工具时,单个结果还可能再增加多达 25,000。The AI Hive 上下文包保持在您为每个应用设定的 token 预算之内(500 至 100,000)。
约 −66%
仅在连接器只为需要它们的任务开启、而非始终开启时,一个模拟开发者日中处理的 token 数。
每个人自己的连接器
- 原始邮件和文件直达 AI,没有范围、客户隔离、审批或审计
- 已批准的知识与未经批准的原始数据可能互相矛盾,而 AI 分不清哪个是哪个
- 工具定义和大型结果挤占上下文窗口
- 功能重叠的工具会让 AI 选择工具时更容易出错
- 私有数据、不可信的外来内容和发送工具集中在同一个智能体里
通过 The AI Hive 接入的公司数据源
- 在您的服务器上读取;事实由您自己基础设施上的小型模型提取
- 共享知识须经负责人批准,并有客户隔离和审计记录
- AI 获得一个在 token 预算内、标记为数据的上下文包
- 一小套稳定的记忆工具,取代几十个连接器工具
- 连接器只读取;数据只在您设定的地方向外发送(Webhook、邮件、推送)
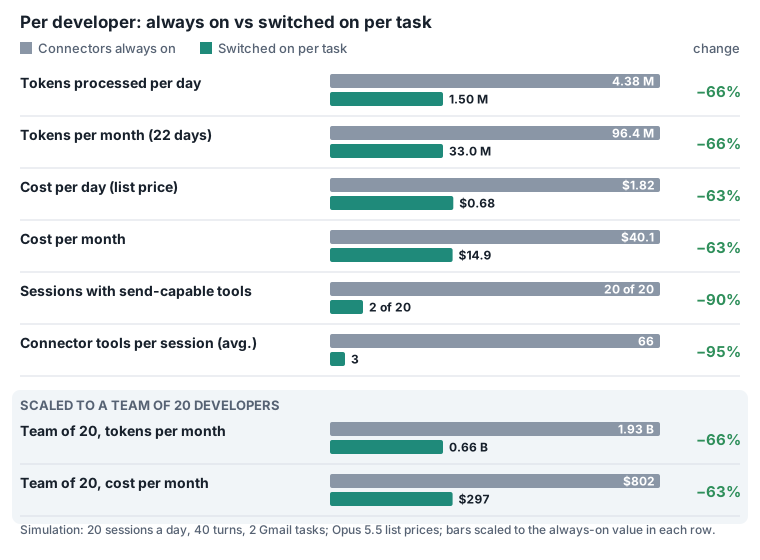
数据来自在 Claude Code 2.1.296 上的一次测试(2026 年 10 月 13 日)和一次带有明确假设的模拟;方法和来源见我们的研究笔记What connectors cost。已构建的连接器:Jira Cloud(只读)、通过 IMAP 的邮箱和 PostgreSQL 视图,以及 git 仓库到项目的映射;已在测试副本上测试,尚未在真实账户上测试;Microsoft 365 和 Gmail 登录在路线图上。
我们的立场
我们是什么,以及我们目前还不是什么
The AI Hive 的优势所在
- 一套由人员和多种不同 AI 应用通过 MCP 和 REST 共享的记忆;可更换供应商或同时使用多家(多供应商接入正在测试中)
- 提升、继承和综合,均需明确批准
- 用于将资料分隔开的客户隔离墙和受众标签
- 记录 AI 当时知道什么的审计轨迹
- 设计为在您的云端或本地部署(计划中,暂未提供)
我们坦率说明局限的地方
- The AI Hive 正在开发中,并已在我们自己的模拟环境中测试。它在大规模场景下尚不成熟,大规模负载测试在路线图上。
- 我们有意只覆盖一小部分只读连接器,且仅在测试副本上测试过。
- 不适合非常小的团队或一次性的工作。
您的员工不会被迫使用某一品牌的笔记本电脑或邮件客户端。那么您的 AI 记忆为什么要被锁定在某一个模型上?